

在本文档中,您将学习如何使用地点计数函数,通过 Places Insights 中的地点 ID 示例数据,以及有针对性的地点详情查询,来提高结果的可信度。
如需查看此模式的详细参考实现,请参阅以下说明性笔记本:
 在 Google Colab 中运行
 在 GitHub 上查看源代码
架构模式
此架构模式为您提供了一个可重复的工作流,以弥合高级统计分析与标准答案验证之间的差距。通过将 BigQuery 的规模与 Places API 的精确度相结合,您可以自信地验证分析结果。这对于选址、竞争对手分析和市场调研尤其有用,因为在这些场景中,对数据的信任至关重要。
此模式的核心涉及四个关键步骤:
- 执行大规模分析:在 BigQuery 中使用地点数据分析中的地点计数函数,分析大范围地理区域(例如整个城市或地区)的地点数据。
- 隔离和提取样本:从汇总结果中识别感兴趣的区域(例如,高密度的“热点”),并提取函数提供的
sample_place_ids。 - 检索标准答案详情:使用提取的地点 ID 有针对性地调用 地点详情 API,以获取每个地点的丰富真实世界详情。
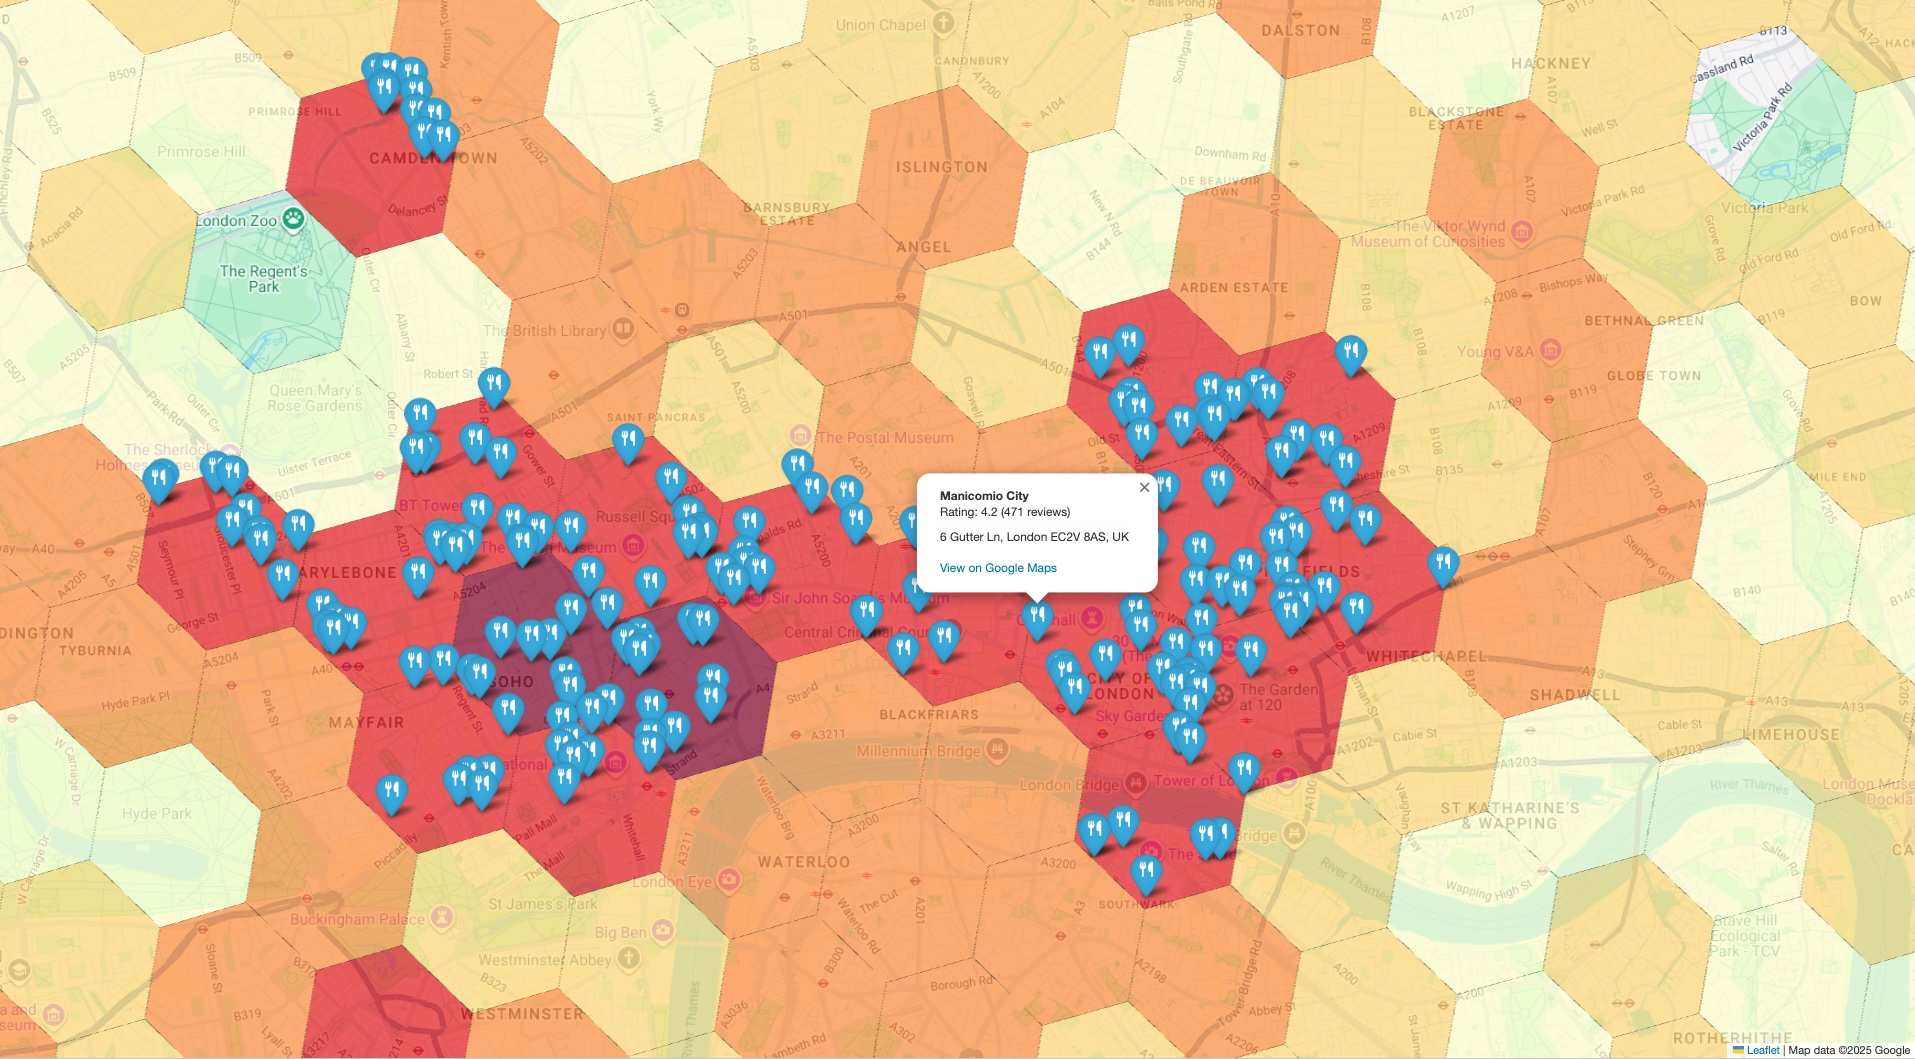
- 创建组合可视化图表:将详细的地点数据叠加在初始的高级统计地图上,以直观验证汇总计数是否反映了实际情况。
解决方案工作流
此工作流可让您弥合宏观趋势与微观事实之间的差距。您首先从广泛的统计视图开始,然后有策略地深入探究,通过具体的实际示例验证数据。
利用地点数据分析大规模分析地点密度
第一步是大致了解整体情况。您可以运行单个查询来获取统计摘要,而无需提取数千个单独的地图注点 (POI)。
地点数据分析 PLACES_COUNT_PER_H3 函数非常适合此用途。它会将地图注点计数汇总到六边形网格系统 (H3) 中,让您能够根据特定条件(例如,评分高且正在营业的餐厅)快速识别密度高或低的区域。
示例查询如下。请注意,您需要提供搜索区域地理位置。开放数据集(例如 Overture Maps Data BigQuery 公共数据集)可用于检索地理边界数据。
对于常用的开放数据集边界,我们建议您将其具体化到您自己项目中的表中。这可以显著降低 BigQuery 费用并提高查询性能。
-- This query counts all highly-rated, operational restaurants
-- across a large geography, grouping them into H3 cells.
SELECT *
FROM
  `places_insights___gb.PLACES_COUNT_PER_H3`(
    JSON_OBJECT(
      'geography', your_defined_geography,
      'h3_resolution', 8,
      'types', ['restaurant'],
      'business_status', ['OPERATIONAL'],
      'min_rating', 3.5
    )
  );
按品牌 ID 过滤和验证
如果您想验证特定品牌的数量和示例地点 ID,请使用 brand_ids 过滤条件提供品牌 ID 列表。
如需获取目标品牌的品牌 ID,请在 BigQuery 中查询 brands 表:
SELECT id, name
FROM `YOUR_PROJECT.places_insights___us.brands`
WHERE LOWER(name) LIKE "%starbucks%";
检索到目标品牌 ID(例如,星巴克的 ID 为 "1413758728321880760")后,将其传入 brand_ids 过滤条件数组中:
SELECT *
FROM
  `places_insights___us.PLACES_COUNT_PER_H3`(
    JSON_OBJECT(
      'geography', your_defined_geography,
      'h3_resolution', 8,
      'brand_ids', ["1413758728321880760"]
    )
  );
在第 3 步(标准答案验证)中,您可以使用正则表达式匹配,以程序化方式将地点详情 API 返回的显示名称与您预期的品牌名称进行比较,而不是确认地点是否与一般类别匹配。例如,您可以比较 response.display_name.text 字段。
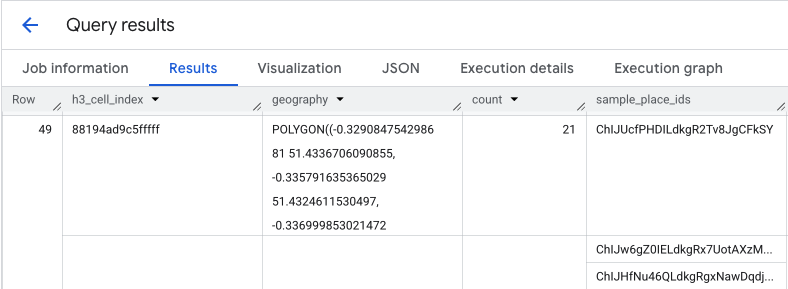
此查询的输出会为您提供一个包含 H3 单元格和每个单元格内地点数量的表格,从而构成密度热图的基础。
隔离热点并提取示例地点 ID
PLACES_COUNT_PER_H3 函数的结果还会返回一个 sample_place_ids 数组,响应的每个元素最多包含 250 个地点 ID。这些 ID 是汇总统计信息与构成该统计信息的各个地点之间的关联。
系统可以先根据初始查询找出相关度最高的单元格。
例如,您可以选择计数最高的前 20 个单元格。然后,从这些热点中,将 sample_place_ids 整合到一个列表中。此列表代表了从最相关区域中精选出的最有趣 POI 样本,可帮助您做好针对性验证的准备。
如果您在 Python 中使用 pandas DataFrame 处理 BigQuery 结果,则提取这些 ID 的逻辑很简单:
# Assume 'results_df' is a pandas DataFrame from your BigQuery query.

# 1. Identify the 20 busiest H3 cells by sorting and taking the top results.
top_hotspots_df = results_df.sort_values(by='count', ascending=False).head(20)

# 2. Extract and flatten the lists of sample_place_ids from these hotspots.
# The .explode() function creates a new row for each ID in the lists.
all_sample_ids = top_hotspots_df['sample_place_ids'].explode()

# 3. Create a final list of unique Place IDs to verify.
place_ids_to_verify = all_sample_ids.unique().tolist()

print(f"Consolidated {len(place_ids_to_verify)} unique Place IDs for spot-checking.")
如果使用其他编程语言,也可以应用类似的逻辑。
使用 Places API 检索标准答案详情
有了整合后的地点 ID 列表,您现在可以从大规模分析过渡到特定数据检索。您将使用这些 ID 查询 Place Details API,以获取每个示例地点的详细信息。
这是关键的验证步骤。地点数据分析会告诉您某个区域内有多少家餐厅,而 Places API 则会告诉您这些餐厅具体是哪些,并提供其名称、确切地址、纬度/经度、房客评分,甚至还会提供指向其在 Google 地图上的位置的直接链接。这会丰富您的示例数据,将抽象 ID 转换为具体、可验证的地点。
如需查看 Place Details API 提供的完整数据列表以及与检索相关的费用,请参阅 API 文档。
使用 Python 客户端库向 Places API 发出针对特定 ID 的请求,如下所示。如需了解详情,请参阅 Places API(新版)客户端库示例。
# A request to fetch details for a single Place ID.
request = {"name": f"places/{place_id}"}

# Define the fields you want returned in the response as a comma-separated string.
fields_to_request = "formattedAddress,location,displayName,googleMapsUri"

# The response contains ground truth data.
response = places_client.get_place(
    request=request,
    metadata=[("x-goog-fieldmask", fields_to_request)]
)
请注意,此请求中的字段会从两个不同的结算 SKU 中提取数据。
formattedAddress和location属于地点详情基本功能版 SKU。displayName和googleMapsUri属于地点详情 Pro SKU。
如果单个“地点详情”请求包含来自多个 SKU 的字段,则整个请求将按最高层级 SKU 的费率结算。因此,此特定调用将作为“地点详情 Pro”请求进行结算。
为了控制费用,请始终使用 FieldMask 仅请求应用所需的字段。
创建组合可视化图表以进行验证
最后一步是将两个数据集整合到一个视图中。这提供了一种直观、快捷的方法来抽查您的初步分析。您的可视化图表应包含两个图层:
- 基础图层:根据初始
PLACES_COUNT_PER_H3结果生成的等值线图或热图,显示您所在地理区域内地点的整体密度。 - 顶层:一组针对每个示例 POI 的单独标记,使用上一步中从 Places API 检索到的精确坐标绘制。
以下伪代码示例展示了构建此组合视图的逻辑:
# Assume 'h3_density_data' is your aggregated data from Step 1.
# Assume 'detailed_places_data' is your list of place objects from Step 3.

# Create the base choropleth map from the H3 density data.
# The 'count' column determines the color of each hexagon.
combined_map = create_choropleth_map(
    data=h3_density_data,
    color_by_column='count'
)

# Iterate through the detailed place data to add individual markers.
for place in detailed_places_data:
    # Construct the popup information with key details and a link.
    popup_html = f"""
    <b>{place.name}</b><br>
    Address: {place.address}<br>
    <a href="{place.google_maps_uri}" target="_blank">View on Maps</a>
    """

    # Add a marker for the current place to the base map.
    combined_map.add_marker(
        location=[place.latitude, place.longitude],
        popup=popup_html,
        tooltip=place.name
    )

# Display the final map with both layers.
display(combined_map)
通过在高级密度图上叠加特定的标准答案标记,您可以立即确认被标识为热点的区域确实包含大量您正在分析的地点。这种直观的确认方式可显著增强对数据驱动型结论的信任。
总结
此架构模式提供了一种可靠且高效的方法来验证大规模地理空间数据洞见。通过利用地点数据分析进行广泛、可扩展的分析,并利用地点详情 API 进行有针对性的标准答案验证,您可以创建一个强大的反馈环。这可确保您的战略决策(无论是零售选址还是物流规划)都基于具有统计显著性且可验证准确性的数据。
后续步骤
- 探索其他地点计数函数,了解它们如何解答不同的分析问题。
- 请参阅 Places API 文档,了解您可以请求的其他字段,以进一步丰富您的分析。
贡献者
Henrik Valve | DevX 工程师